Fünf Best Practices für mehr NachverfolgbarkeitKI-Compliance braucht Knowledge Layer
12. Oktober 2026
Die meisten KI-Systeme in Unternehmen entstanden, bevor es ein verbindliches KI-Regelwerk gab. Mit dem EU AI Act liegt nun ein Rahmen vor, der Compliance zur Architekturfrage macht. Fünf Best Practices zeigen, wie IT-Verantwortliche ihre KI transparent, kontrollierbar und prüfungssicher aufsetzen können.
Neue Richtlinien und Prozesse allein genügen nicht. Unternehmen müssen auch Datenflüsse, Modellzugriffe und Systemarchitekturen neu bewerten. Besonders anspruchsvoll wird das bei KI-Systemen, die der AI Act als hochriskant einstuft, sowie bei Anwendungen, die biometrische Daten verarbeiten oder Personen- und Verhaltensprofile erstellen. Je nach Verstoß drohen bis zu 35 Millionen Euro oder sieben Prozent des weltweiten Jahresumsatzes.
Transparenz, Verantwortlichkeit und Rückverfolgbarkeit sind damit keine freiwilligen Architekturprinzipien mehr, sondern konkrete Voraussetzungen für einen regelkonformen Betrieb. Für IT-Verantwortliche stellt sich deshalb nicht mehr die Frage, ob sie Compliance technisch abbilden müssen. Entscheidend ist, ob ihre bestehenden Architekturen das überhaupt leisten können.
Wie KI den Datenschutz unterläuft
Besonders deutlich zeigen sich architektonische Schwächen beim Umgang mit sensiblen Daten. In der Enterprise-IT treten dabei meist zwei Arten von Verstößen auf. Im ersten Fall legt das System vertrauliche Informationen gegenüber unberechtigten Personen oder Rollen beziehungsweise über ungeeignete Kanäle offen. Im zweiten Fall nutzt es Daten für unzulässige oder nicht vorgesehene Zwecke. Damit berührt KI nicht nur den Datenschutz, sondern auch Zugriffskontrolle, Zweckbindung und Data Governance.
Sobald KI-Agenten ins Spiel kommen, steigen beide Risiken deutlich. Anders als ein einzelnes Modell, das lediglich eine Antwort liefert, bearbeiten agentische Systeme ganze Aufgabenfolgen selbstständig. In Multi-Agenten-Workflows speist jedes Ergebnis den nächsten Prozessschritt. Da LLMs nicht strikt regelbasiert arbeiten, sondern Wahrscheinlichkeiten aus Mustern ableiten, können sich Fehlannahmen entlang der Kette fortpflanzen und weitere Fehlentscheidungen auslösen.
Eine weitere Herausforderung ist die Erklärbarkeit. In geschäftskritischen Prozessen wird die Blackbox KI schnell zum Compliance-Risiko. Unternehmen müssen nachvollziehen können, welche Daten in eine Entscheidung eingeflossen sind, ob ihre Nutzung zulässig war und wie das Ergebnis zustande kam. Nur dann lassen sich Verantwortlichkeiten zuordnen und regulatorische Nachweise führen.
Architektur-Fix: Knowledge Layer aufbauen
Wer KI regelkonform betreiben will, braucht mehr als den Zugriff auf Daten. Dafür braucht es ein strukturiertes Verständnis davon, wie das Unternehmen funktioniert: wo Informationen liegen, wie Entitäten zusammenhängen, welche Regeln gelten und warum diese Beziehungen relevant sind. Eine Knowledge Layer bildet dieses Wissen ab und macht es für KI-Systeme nutzbar. Sie verbindet dazu mehrere Bausteine:
- Knowledge Graphs und Ontologien für domänenspezifisches Unternehmenswissen,
- Kontext- und Agentengedächtnis für die aktuelle Situation,
- Geschäftsregeln und Policies für interne Vorgaben und regulatorische Anforderungen sowie
- Workflows, Entscheidungsspuren und menschliches Feedback für nachvollziehbare Abläufe und kontinuierliche Verbesserung.
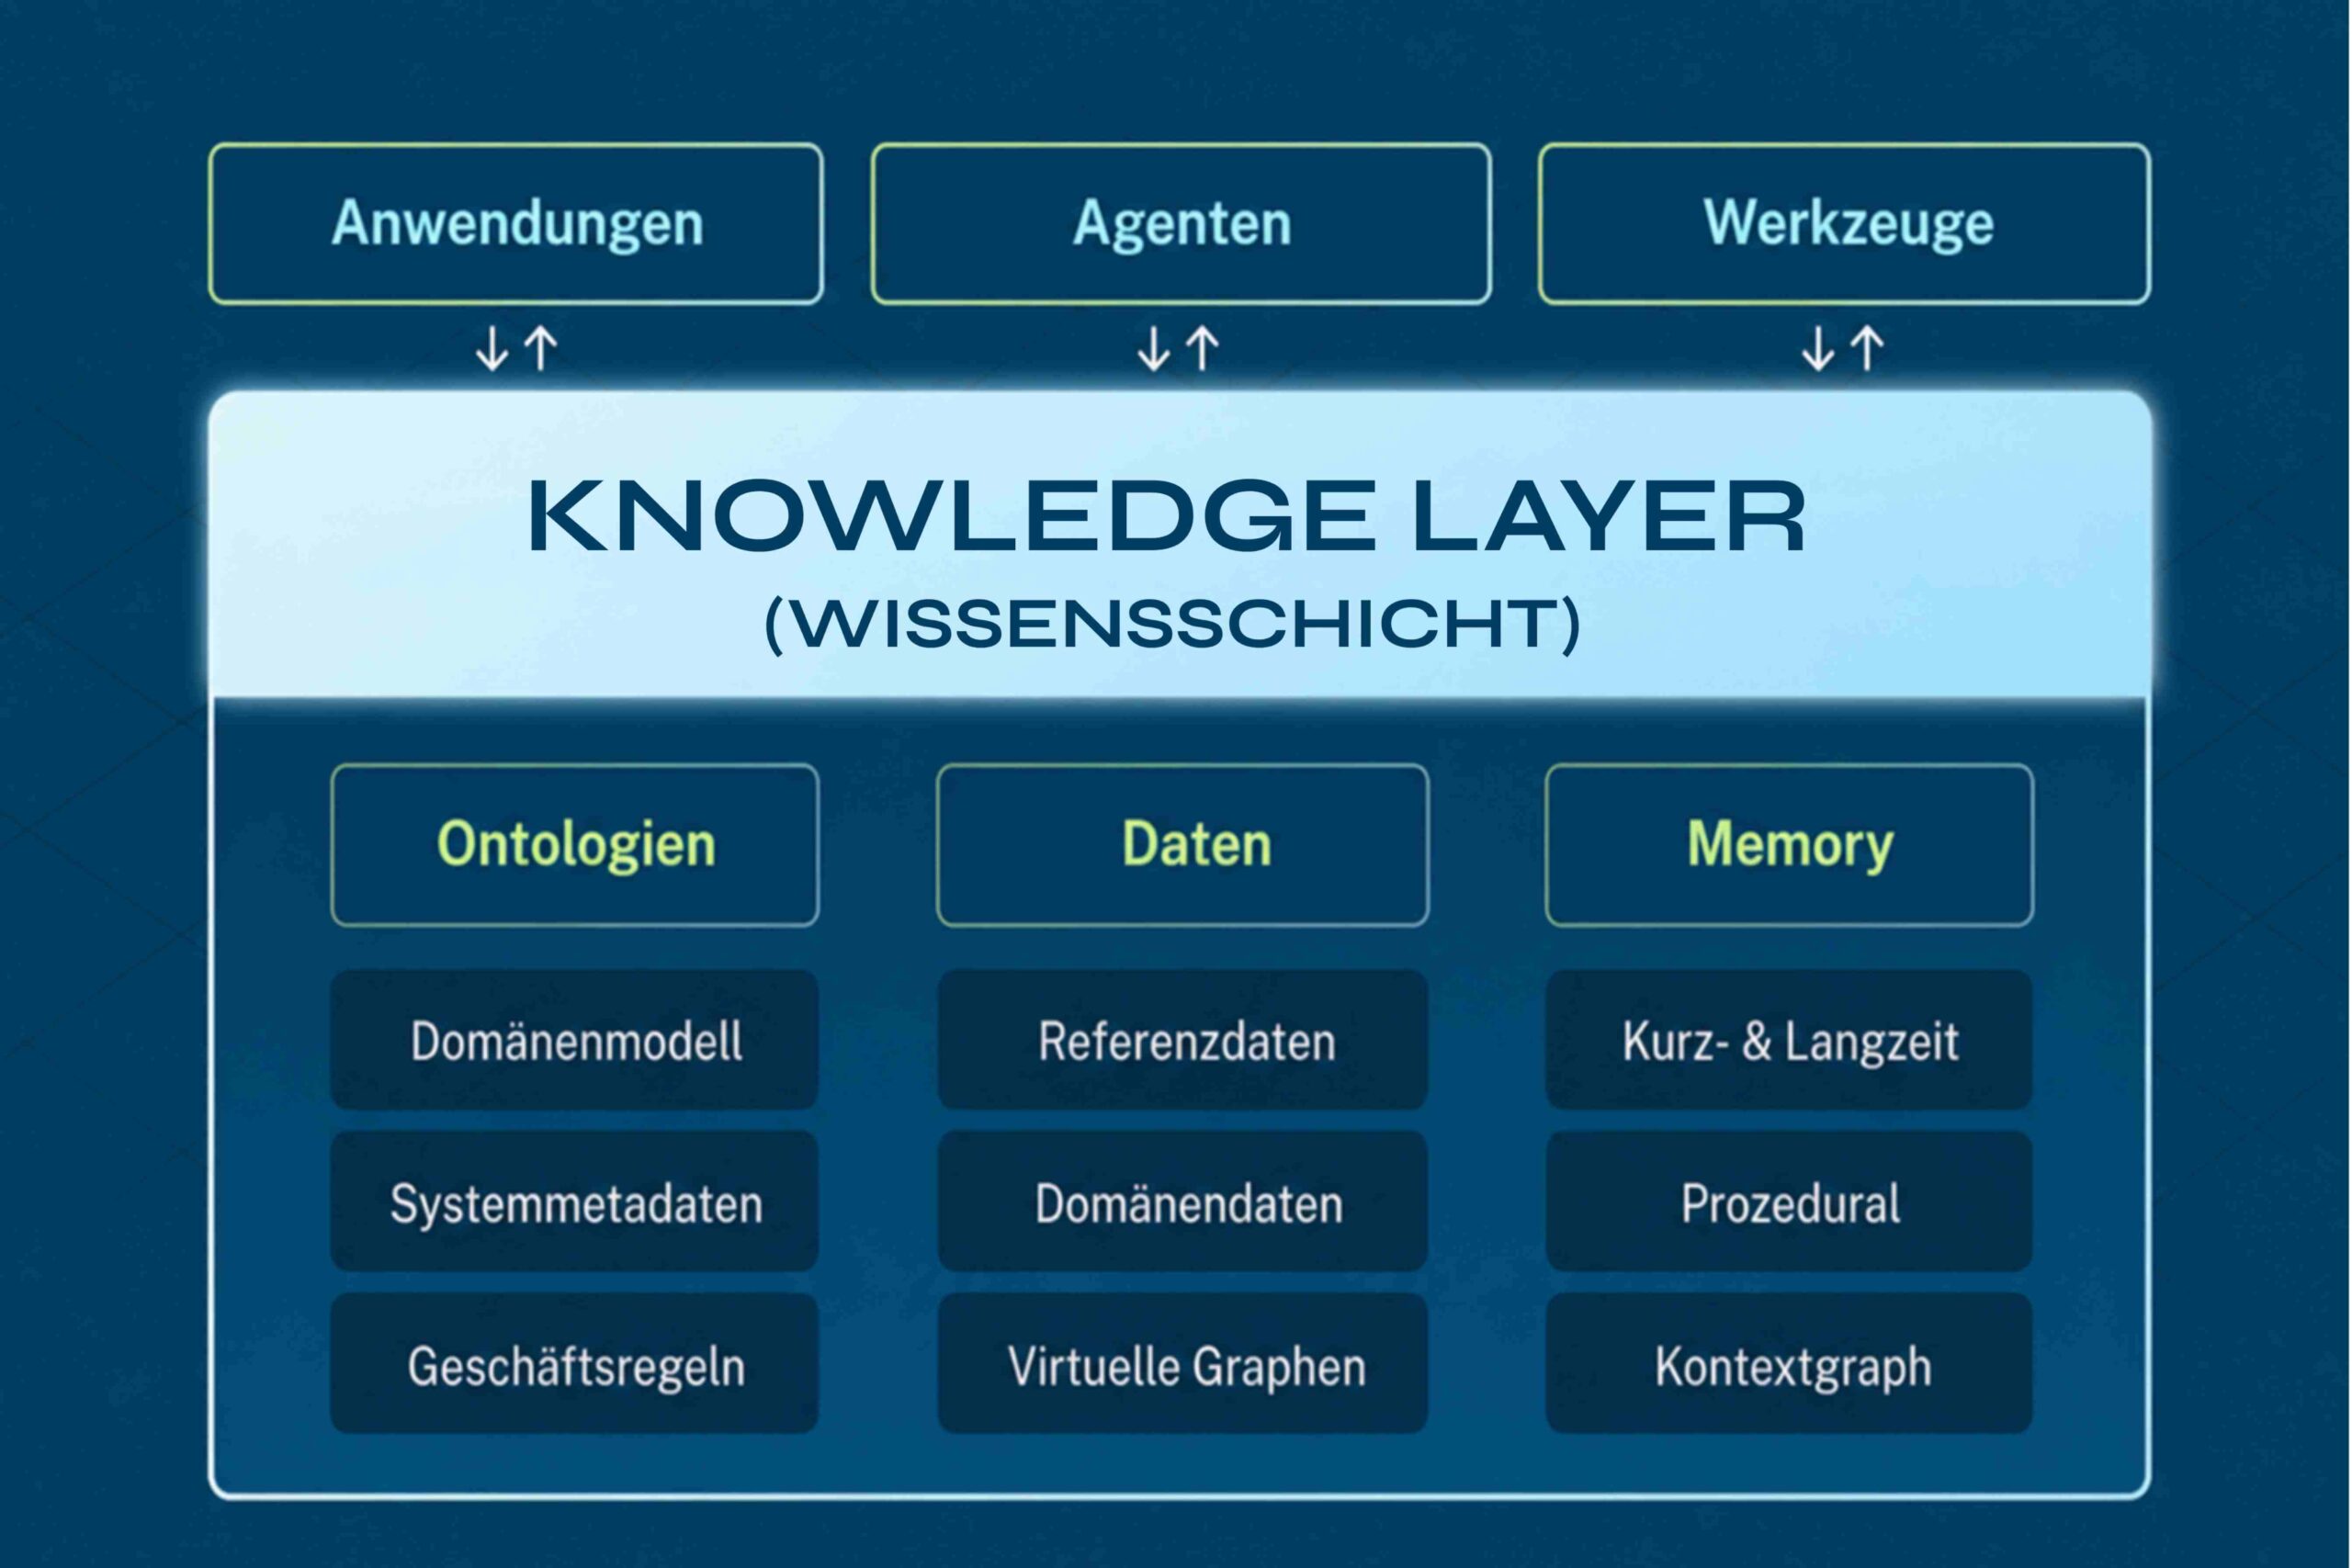
Das technische Fundament einer solchen Wissensschicht bildet ein Knowledge Graph. Er modelliert Entitäten, Beziehungen und fachliche Zusammenhänge explizit und macht ihre Herkunft nachvollziehbar. Genau das ist der Grundgedanke von Graphrag: Der Ansatz verbindet die sprachlichen Fähigkeiten von LLMs mit der strukturellen Präzision eines Knowledge-Graphen und bindet den KI-Output an die Unternehmens- und Compliance-Realität.
Die Systeme erhalten genau den Kontext, der für den nächsten Schritt oder die nächste Entscheidung nötig ist. Neben menschlichem Input – etwa Nutzeranfragen, Korrekturen und Systemprompts – gehört dazu auch die kognitive Steuerung für die Planung und Bewertung (u.a. Policies, Prioritäten, Metadaten). Eine wichtige Kontextquelle stellt zudem die Gedächtnisschicht eines LLM dar (u. a. Session State, Zwischenergebnisse, persistentes Langzeitwissen). Und mit agentischer KI werden schließlich die Datenquellen und Werkzeuge selbst Teil des Kontexts.
Der Knowledge Layer liefert der KI damit einen präzisen Rahmen, um Informationen situativ abzurufen, einzuordnen, zu verarbeiten oder zu verwerfen. Herkunft und Pfade bleiben dabei transparent und schaffen die Grundlage für Governance, Zugriffskontrolle und Auditierbarkeit. Erst diese Kombination aus Kontext, Gedächtnis, Entscheidungslogik und Kontrollmechanismen macht KI im Unternehmensalltag verlässlich einsetzbar.
Fünf Best Practices
Eine Knowledge Layer schafft die technische Grundlage für regelkonforme KI. Ob daraus ein belastbares Governance-Modell entsteht, entscheidet sich jedoch an ihrer konkreten Ausgestaltung. Die folgenden fünf Best Practices zeigen, wie Unternehmen Transparenz, Kontrolle und Auditierbarkeit in Architektur und Betrieb verankern können.
- Nachvollziehbarkeit als Produktanforderung: Ein belastbarer Audit Trail muss mehr erfassen als Prompt und Antwort. Für jeden Vorgang sollten Unternehmen auch den abgerufenen Kontext, die verwendeten Datenquellen, Tool-Aufrufe, Berechtigungs- und Policy-Prüfungen sowie daraus ausgelöste Aktionen protokollieren. Dazu gehören außerdem die jeweils eingesetzten Versionen von Modell, Systemprompt und Regelwerk. Eine gemeinsame Trace-ID verbindet diese Informationen über alle Schritte eines agentischen Workflows hinweg. Bei abgerufenen Dokumenten, Datensätzen oder Graph-Entitäten sollte zusätzlich feststehen, aus welcher Quelle und Version sie stammen und auf welcher Berechtigung der Zugriff beruht. Nur so lässt sich eine Entscheidung später vollständig rekonstruieren.
- Identitäten systemübergreifend auflösen: Auskunfts- oder Löschanfragen lassen sich nur vollständig bearbeiten, wenn Unternehmen eine Person über alle Systeme hinweg eindeutig identifizieren können. Dafür müssen sie Kundenkonten, Logins, E-Mail-Adressen und Telefonnummern ebenso zusammenführen wie Gerätekennungen, Cookies, Sessions und andere Online-Identifikatoren. Ein gemeinsamer Identitätsschlüssel oder Identity Graph kann diese Verbindungen abbilden und für jede Zuordnung festhalten, aus welchem System sie stammt. Eindeutige Merkmale lassen sich regelbasiert verknüpfen. Bei unsicheren Übereinstimmungen können Konfidenzwerte und Prüfschwellen helfen. Jede Zuordnung sollte außerdem mit dem jeweiligen Verarbeitungs- oder Offenlegungszweck verbunden sein. So kann das System ermitteln, welche Datenspuren zu einer Person gehören und für welchen Zweck sie verwendet werden dürfen.
- Datenzugriff von der Modellausführung trennen: Kontrollierte Unternehmensdaten sollten dem Modell nicht dauerhaft und uneingeschränkt zugänglich sein. Stattdessen liegen sie in einer separat verwalteten Knowledge Layer, aus der das System den benötigten Kontext erst zur Laufzeit abruft. Datenquellen, Metadaten und Zugriffsregeln bleiben dadurch unabhängig vom Modell steuerbar und aktualisierbar. Vor jeder Abfrage muss die Zugriffsschicht prüfen, welcher Nutzer welche Informationen für welchen Zweck verwenden darf. Dazu wertet sie Identität, Rolle, Datenklassifikation und geltende Policies aus und gibt nur den zulässigen Kontext an das Modell weiter. Änderungen an Berechtigungen, Einwilligungen oder Löschanforderungen können so unmittelbar für künftige Abrufe greifen. Informationen, die bereits in Modellgewichte eingeflossen sind, müssen dagegen separat behandelt werden.
- Deterministische Logik für eindeutige Entscheidungen nutzen: Wo Regeln ein eindeutiges und wiederholbares Ergebnis verlangen, lässt sich die Entscheidungslogik von der probabilistischen Modellausgabe trennen. Ein LLM kann beispielsweise Informationen aus unstrukturierten Dokumenten extrahieren oder relevante Entitäten erkennen. Die eigentliche Bewertung kann anschließend über versionierte Geschäftsregeln, Schwellenwerte oder Abfragen auf dem Knowledge Graph erfolgen. Das System liefert so neben dem Ergebnis auch die dafür maßgeblichen Fakten und Regeln. Das ist besonders bei mehrstufigen Workflows relevant, da sich Unsicherheiten über mehrere probabilistische Verarbeitungsschritte hinweg verstärken können. Deterministische Multi-Hop-Abfragen können Beziehungen entlang definierter Pfade auswerten und unter gleichen Voraussetzungen reproduzierbare Ergebnisse liefern. Modellbasierte Prüfungen lassen sich ergänzend einsetzen, um Zwischenergebnisse zu bewerten oder Abweichungen zu erkennen.
- Agentische Workflows prüfbar gestalten: Bei agentischen Workflows reicht es nicht, Entscheidungsspuren lediglich zu speichern. Sie sollten sich auch durch Menschen oder andere Agenten gezielt auswerten lassen. Dafür können Unternehmen beispielsweise maschinenlesbare Prüfkriterien, Risikoschwellen und Eskalationsregeln definieren, anhand derer sich Zwischenergebnisse und ausgelöste Aktionen bewerten lassen. Auffällige oder uneindeutige Vorgänge können so für eine zusätzliche Prüfung markiert werden. Die Ergebnisse dieser Prüfungen lassen sich in einen Feedbackkreislauf überführen. Bestätigte Fehler, Korrekturen und manuelle Eingriffe können etwa als strukturierte Evaluationsdaten erfasst und für Tests, Policies oder Freigaberegeln künftiger Ausführungen genutzt werden. So wird Auditierbarkeit nicht nur zum nachträglichen Nachweis, sondern auch zur Grundlage für die kontinuierliche Verbesserung agentischer Systeme.
Governance und Qualität sind keine getrennten Investitionen. Dieselbe Architektur, die regulatorische Anforderungen erfüllt, verbessert auch Verlässlichkeit, Ergebnisqualität und damit letztlich die Kostensteuerung von KI-Systemen. Der tragfähigere Ansatz besteht deshalb darin, Compliance nicht nachträglich aufzusetzen, sondern von Anfang an in der KI-Architektur mitzudenken.
Konrad Hippius ist bei Neo4j als Enterprise Executive tätig.